
位置编码与上下文扩展方法
Published:
摘要
本文回顾了常见的位置编码方法,以及扩展语言模型上下文长度的各种思路,从正弦位置嵌入、相对位置偏置,一直讲到 RoPE 及其扩展。在介绍数学形式的同时,我也分享自己对这些方法的理解:它们如何编码位置、如何与词元内容交互,以及超出训练上下文长度后会有怎样的表现——为什么有效、在哪里失效,以及这些局限揭示了什么。本文希望将位置编码背后的直觉,与上下文扩展中的设计选择和权衡联系起来。
1. 位置编码
1.1 正弦位置编码
符号说明
| 符号 | 含义 |
|---|---|
| \(pos\) | 词元位置(从 0 开始)。 |
| \(d\) | 模型/嵌入维度,此处假设为偶数。 |
| \(i\) | 维度对索引,范围为 0 至 d/2−1;本节不是词元位置。 |
| \(\mathrm{PE}(pos,2i),\mathrm{PE}(pos,2i+1)\) | 位置编码的正弦分量和余弦分量。 |
| \(k\) | 两个词元位置之间的固定偏移。 |
| \(\pi\) | 圆周率;一整圈为 2π 弧度。 |
最初的 Transformer1 在每个位置 \(pos\) 的词元嵌入上加上一个固定的编码。对于 \(i = 0, \dots, d/2-1\),其中 \(d\) 是模型维度,
\[ \mathrm{PE}(pos, 2i) = \sin\left(\frac{pos}{10000^{2i/d}}\right), \qquad \mathrm{PE}(pos, 2i + 1) = \cos\left(\frac{pos}{10000^{2i/d}}\right). \]
- 各频带的周期从 \(2\pi\)(最快频带)到约 \(20000\pi\)(最慢频带)不等。
- 作者推测,这种设计让模型能够轻松学会根据相对位置分配注意力,因为对于任意固定偏移量 \(k\),\(\mathrm{PE}(pos + k)\) 都是 \(\mathrm{PE}(pos)\) 的线性函数。
1.2 可学习的绝对位置编码
每个位置都有一个可学习的嵌入,并将其加到该位置的词元嵌入上。这些位置嵌入随机初始化,与模型一起训练。
1.3 T5 相对位置偏置5
符号说明
| 符号 | 含义 |
|---|---|
| \(i,j\) | 查询与键的词元位置(i 的含义与 1.1 节不同)。 |
| \(l,h\) | 层索引与注意力头索引。 |
| \(q_i^{(l,h)},k_j^{(l,h)}\) | 对应层和注意力头中的查询向量与键向量。 |
| \(s(i,j)^{(l,h)}\) | softmax 之前的注意力分数。 |
| \(M_{i,j}\) | 注意力掩码偏置:允许关注的位置对通常为 0,被屏蔽的为 −∞。 |
| \(d\) | 分桶公式中的相对距离 |i−j|;此处不是嵌入维度。 |
| \(B,D\) | 桶数与最大距离参数(远距离共用最后一个桶)。 |
| \(g(d),\mathrm{bucket}(d)\) | 距离 d 对应的桶索引;对数部分所得索引向下取整。 |
| \(b^{(h)}\) | 第 h 个注意力头的可学习位置偏置表,各层共享。 |
| \(\top,\log,\min\) | 转置、对数和取最小值。 |
T5 不在各个位置上添加位置嵌入,而是直接为每个注意力得分(logit)加上一个偏置。这个偏置由相对位置决定。
对于第 \(l\) 层、第 \(h\) 个注意力头中的位置 \(i\) 和 \(j\),注意力得分 \(s_{i, j}^{(h, l)}\) 定义为
\[ s(i, j)^{(l,h)} = (q_i^{(l,h)})^\top k_j^{(l,h)} + b_{\textrm{bucket}(\mid i-j\mid)}^{(h)} + M_{i,j}, \]
其中,\(b_{\textrm{bucket}(d)}^{(h)}\) 是第 \(h\) 个注意力头在相对距离 \(d\) 处的位置偏置。在 T5 的实现中,各层共享位置偏置,因此它的上标只有索引 \(h\)。
分桶的设计思路是:对近处位置提供较细的分辨率,对远处位置提供较粗的分辨率。假设桶的数量为 \(B\),最大距离为 \(D\),桶索引 \(g(d)\) 定义为
\[ g(d) = \begin{cases} d & d < B/2 \\ \min(B - 1, B/2 + \frac{\log(2d/B)}{\log(2D/B)}\cdot\frac{B}{2}) & d \geq B/2. \end{cases} \]
这样,最近的每个相对位置都独占一个桶;距离越远,桶就越大,分辨率也就越粗。
例如,在一个简化设定中,取 \(B = 8\)、\(D = 64\)(桶索引向下取整;T5 实际采用 \(B = 32\)、\(D = 128\)):
| \(d\) | 0 | 1 | 2 | 3 | 4–7 | 8–15 | 16–31 | ≥32 |
|---|---|---|---|---|---|---|---|---|
| 桶索引 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
1.3.1 T5 相对位置偏置是一种带偏置的 NoPE
符号说明
| 符号 | 含义 |
|---|---|
| \(q_i,k_j\) | 内容查询/键向量,省略了层和注意力头索引。 |
| \(p_i^q,p_j^k\) | 查询与键的加性位置向量;上标 q/k 是标签。 |
| \(i-j\) | 带符号的相对位置。 |
我对相对位置偏置的思考
对于加法式位置编码 \(p\),将其加到 \(q\) 和 \(k\) 上,等价于在注意力得分上添加偏置:
\[ (q_i + p^q_i)^\top (k_j + p^k_j) = (q_i)^\top k_j + (q_i)^\top p_j^k + (p_i^q)^\top k_j + (p_i^q)^\top p_j^k \]
其中,\((p_i^q)^\top p_j^k\) 是仅由位置决定的偏置,而 \((q_i)^\top p_j^k + (p_i^q)^\top k_j\) 则是由语义与位置的交互决定的偏置。
然而,这些偏置通常依赖于绝对位置 \(i\) 和 \(j\),这并不是我们想要的。我们希望位置的影响只取决于相对距离 \(i - j\)。
T5 的相对位置偏置只依赖相对距离,却没有语义与位置之间的交互。这种交互仍然很有用。例如,词元“tion”的含义高度依赖前一个词元,而词元“France”对前一个词元的依赖就小得多。因此,一个词元应当多大程度地关注相邻词元,取决于它的语义。我们需要一种既依赖语义、又依赖相对距离,但不依赖绝对位置的位置偏置。RoPE 6 正是提供了这一点。
不过,既然缺少这种语义依赖,T5 的相对位置偏置为什么仍然有效?一个原因是,模型可以跨层建立这种依赖:具有很强局部偏好的注意力头,可以将前一个词元的信息复制到当前隐藏状态中,这样后续层的 \(q\) 和 \(k\) 就已经包含了感知位置信息的内容。在因果解码器中,因果掩码也会透露顺序信息,因为一个词元可以根据自己能看到多少个词元来推断自身位置。这也是为什么不使用任何位置编码(NoPE)的因果语言模型,仍然能够学到位置信息7。
所以,T5 相对位置偏置基本上就是 NoPE,再加上一个按注意力头分别学习、以分桶后的相对距离为输入的偏置。这个偏置没有被约束为随距离衰减,而且所有超过 \(D\) 的距离都共用最后一个桶。
1.4 旋转位置嵌入(RoPE)
符号说明
| 符号 | 含义 |
|---|---|
| \(q_i,k_j\) | 位置 i 的查询向量与位置 j 的键向量。 |
| \(f(x,m)\) | 对位置 m 处向量 x 施加的位置变换。 |
| \(g(q_i,k_j,i-j)\) | 期望得到的内容与相对位置函数;不是 T5 的分桶函数 g。 |
| \(s_{\mathrm{RoPE}}(i,j)\) | RoPE 的注意力分数。 |
如上所述,加法式位置编码通常会使注意力得分依赖绝对位置,而 T5 相对位置偏置又缺少语义与位置的交互。Su 等人 6 随后提出了 RoPE:既保留这种交互,又使它只依赖相对位置,同时比基于分桶的偏置更具表达能力。
RoPE 的目标是以一种特定方式编码位置,使注意力得分 \(s(i,j)\) 只成为内容和相对距离的函数:
\[ s_{\textrm{RoPE}}(i,j) = f(q_i, i)^{\top} f(k_j, j) = g(q_i, k_j, i-j) \]
1.4.1 RoPE 背后的直觉
符号说明
| 符号 | 含义 |
|---|---|
| \(z,z_1,z_2\) | 复数。 |
| \(c,c_1,c_2\) | 复数的模(长度)。 |
| \(\theta,\theta_1,\theta_2\) | 复数的辐角,单位为弧度。 |
| \(\mathrm{i}\) | 虚数单位 √−1;不同于位置索引 i。 |
| \(\bar z,\exp\) | 复共轭与指数函数。 |
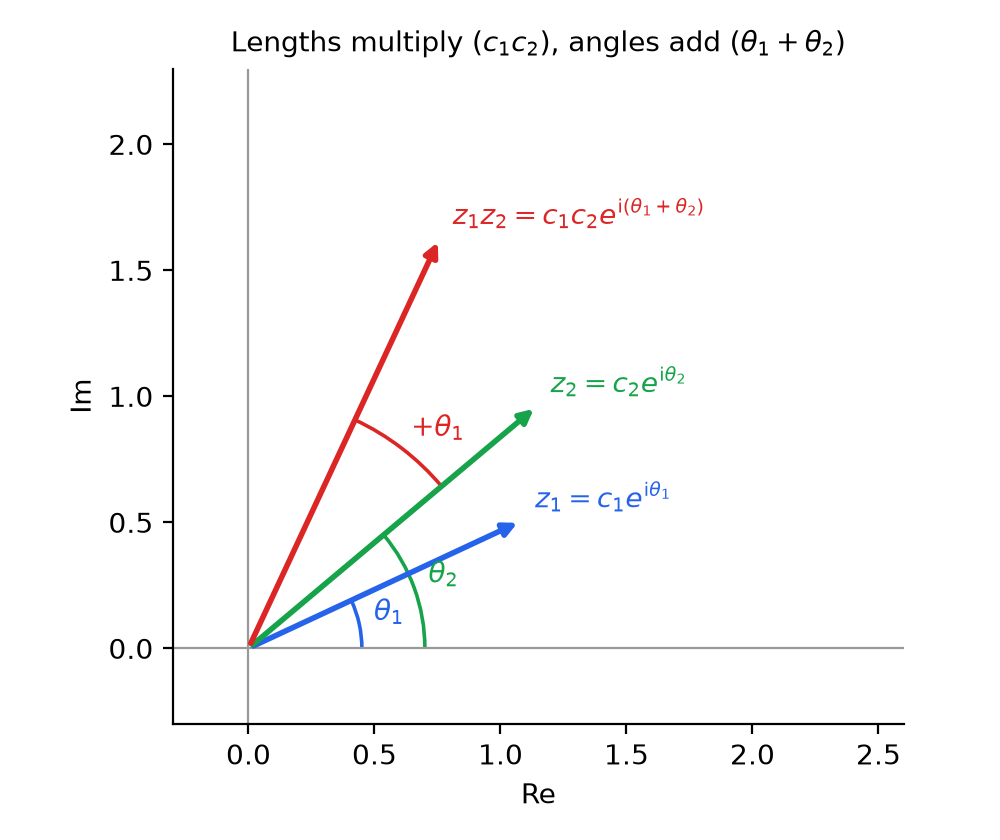
任意复数都可以用模长 \(c\) 和相对于实轴正方向的角度 \(\theta\) 来表示:
\[ z = c\exp(\mathrm{i}\theta) \]
两个复数相乘,只需将模长相乘、角度相加。
\[ z_1 \times z_2 = c_1 c_2 \exp(\mathrm{i}(\theta_1 + \theta_2)) \]
如果让第一个复数乘以第二个复数的共轭,结果就只取决于模长和它们的相对角度。
\[ z_1 \times \bar{z}_2 = c_1 c_2 \exp(\mathrm{i}(\theta_1 - \theta_2)) \]
这个相对角度 \(\theta_1 - \theta_2\),正是我们可以用来表示相对距离的量!
1.4.2 RoPE
符号说明
| 符号 | 含义 |
|---|---|
| \(d,t\) | 偶数的单头维度与维度对索引 t=0,…,d/2−1。 |
| \(q_{i,2t},q_{i,2t+1}\) | 位置 i 的查询向量中,第 t 对的两个实数分量。 |
| \(\tilde q_i^{(t)},\tilde k_j^{(t)}\) | 查询/键第 t 个维度对的复数表示。 |
| \(\theta_t\) | 第 t 个维度对的角频率;t 越小,旋转越快。 |
| \(\mathbb R^d,\mathrm{Re},\sum\) | d 维实向量空间、取实部,以及对维度对求和。 |
为简化说明,我们以单头注意力介绍 RoPE,并忽略注意力掩码(因果掩码)。
设 \(q_i, k_j \in \mathbb{R}^{d}\)(\(d\) 为偶数)分别为位置 \(i\) 处的查询向量和位置 \(j\) 处的键向量。将维度划分为 \(d/2\) 对 \((2t, 2t+1)\),把每一对视为一个复数 \(\tilde{q}_i^{(t)} = q_{i,2t} + \mathrm{i}\, q_{i,2t+1}\)(\(\tilde{k}_j^{(t)}\) 同理),对应频率为 \(\theta_t = 10000^{-2t/d}\),\(t = 0, \dots, d/2-1\)。
变换。 将第 \(t\) 对维度旋转一个角度(位置 \(\times\, \theta_t\)):
\[ f(q_i, i)^{(t)} = \tilde{q}_i^{(t)} \exp(\mathrm{i}\, i\theta_t), \qquad f(k_j, j)^{(t)} = \tilde{k}_j^{(t)} \exp(\mathrm{i}\, j\theta_t). \]
注意力得分。
\[ s_{\textrm{RoPE}}(i,j) = \mathrm{Re}\left[ \sum_{t=0}^{d/2-1} f(q_i, i)^{(t)}\, \overline{f(k_j, j)^{(t)}} \right] = \mathrm{Re}\left[ \sum_{t=0}^{d/2-1} \tilde{q}_i^{(t)}\, \overline{\tilde{k}_j^{(t)}}\, \exp(\mathrm{i}(i-j)\theta_t) \right], \]
它只通过 \(i - j\) 依赖位置。
1.4.3 RoPE 的实现
符号说明
| 符号 | 含义 |
|---|---|
| \(a_1,b_1,a_2,b_2\) | z₁ 与 z₂ 的实部和虚部。 |
| \(q_a,q_b,k_a,k_b\) | 查询和键向量的实部半区与虚部半区。 |
| \(m,\theta\) | 词元位置与各维度对频率组成的向量。 |
| \(u_m,v_m\) | 逐元素计算的 cos(mθ) 和 sin(mθ)。 |
| \(\odot,[q_a;q_b]\) | 逐元素乘法,以及两个半区的拼接。 |
| \(e\) | 自然对数的底数,exp(x)=eˣ。 |
两个复数的这一乘积可以写成
\[ \begin{align} z_1 \times \overline{z_2} &= (a_1 + \mathrm{i}b_1) \times \overline{(a_2 + \mathrm{i}b_2)} \\ &= (a_1 + \mathrm{i}b_1) \times (a_2 - \mathrm{i}b_2)\\ &= a_1a_2 + b_1b_2 + \mathrm{i}(a_2b_1 - a_1b_2). \end{align} \]
因此,实部就是
\[ \textrm{Re} \left[z_1 \times \overline{z_2} \right] = a_1a_2 + b_1b_2, \]
这恰好是 \((a_1, b_1)\) 和 \((a_2, b_2)\) 的实数点积。所以,我们完全不需要实际使用复数:将 \(q\) 和 \(k\) 作为实向量旋转,再计算普通点积即可。
分成两半。 将复向量存为实部和虚部两半:\(q = [q_a; q_b]\) 表示 \(\tilde{q} = q_a + \mathrm{i}\, q_b\)(\(k\) 同理)。于是
\[ \mathrm{Re}\left[\sum \tilde{q} \odot \overline{\tilde{k}}\right] = q_a^\top k_a + q_b^\top k_b = q^\top k, \]
所以,注意力得分就是这两个实向量的普通点积。
旋转。 在位置 \(m\) 旋转 \(\tilde{q}\),意味着乘以 \(e^{\mathrm{i} m\theta} = u_m + \mathrm{i}\, v_m\),其中 \(u_m = \cos(m\theta)\) 和 \(v_m = \sin(m\theta)\) 都是向量,每个频率对应一个分量。使用上述两半的表示,只需要逐元素乘法和加法:
\[ \mathrm{RoPE}(q, m) = \begin{bmatrix} q_a \odot u_m - q_b \odot v_m \\ q_a \odot v_m + q_b \odot u_m \end{bmatrix} = q \odot \begin{bmatrix} u_m \\ u_m \end{bmatrix} + \begin{bmatrix} -q_b \\ q_a \end{bmatrix} \odot \begin{bmatrix} v_m \\ v_m \end{bmatrix}, \]
\(k\) 在其自身位置上的处理方式相同。注意力得分为 \(\mathrm{RoPE}(q, i)^\top \mathrm{RoPE}(k, j)\)。
预计算哪些内容。 频率 \(\theta\) 是固定的,因此可以一次性计算出最大长度以内所有位置 \(m\) 对应的 \(u_m\) 和 \(v_m\),并存为余弦表和正弦表。运行时,只需查出当前位置对应的行,再执行上述逐元素运算。在生成过程中,KV 缓存存储旋转后的键,因此每个键只需旋转一次(这里假设一个词元的旋转不会变化;旋转会变化的情形见 2.3.1)。
1.4.4 影响
在近期的开源大语言模型文献中,RoPE 已成为事实上的位置编码标准。
- LLaMA 系列
- Qwen 系列
- Gemma 系列
- Mistral 系列
- DeepSeek 系列
- ……
1.4.5 RoPE 为什么成功
本节基于我个人的理解。
原论文作者写道:“值得注意的是,RoPE 具备一些有价值的性质,包括序列长度的灵活性、词元间依赖随相对距离增大而衰减,以及为线性自注意力引入相对位置编码的能力。”不过,我认为,模型实际依赖的并不是这种长距离衰减。
论文仅证明了注意力得分的一个上界随距离衰减,而 Barbero 等人 8 表明,这种衰减一般并不成立,例如查询和键随机取值时就不成立。训练后的模型实际表现出的距离偏好,主要来自注意力头之间的功能分工,而非 RoPE 的衰减。
在我的理解中,RoPE 的成功在于:它提供了一种既依赖语义、又依赖相对距离,但不依赖绝对位置的位置偏置(见 1.3)。
1.5 XPos
符号说明
| 符号 | 含义 |
|---|---|
| \(i,j,t,d\) | 查询/键位置、维度对索引及偶数单头维度,沿用 RoPE 定义。 |
| \(\zeta_t\) | 第 t 个维度对的衰减率,介于 0 与 1 之间。 |
| \(\lambda\) | 衰减形状参数,设为 0.4;不是后文的波长 λₜ。 |
| \(\gamma\) | 衰减的距离尺度,设为 512;不是 YaRN 的混合系数 γₜ。 |
| \(s_{\mathrm{XPos}}(i,j)\) | 施加旋转编码及衰减后的注意力分数。 |
此前,人们认为模型无法处理超出训练长度的输入,是因为使用了绝对位置编码。然而,基于 RoPE 的模型虽然消除了对绝对位置的依赖,却仍然无法处理超出训练长度的输入。
Sun 等人 9 将这一问题归因于旋转较快的频带:在距离较大时,这些频带会让注意力得分振荡,而不是衰减,从而给注意力引入噪声,阻碍 RoPE 的外推。因此,他们为 RoPE 加入了显式的距离衰减。每对维度 \(t = 0, \dots, d/2-1\)(与 1.4.2 中的配对索引相同,因此 \(t\) 越小,频带越快)都有一个衰减率:
\[ \zeta_t = \frac{2t/d + \lambda}{1 + \lambda} \in (0, 1), \qquad \lambda = 0.4, \]
并在旋转之前,对查询和键施加方向相反的缩放:
\[ f(q_i, i)^{(t)} = \tilde{q}_i^{(t)}\, \zeta_t^{\,i/\gamma} \exp(\mathrm{i}\, i\theta_t), \qquad f(k_j, j)^{(t)} = \tilde{k}_j^{(t)}\, \zeta_t^{-j/\gamma} \exp(\mathrm{i}\, j\theta_t), \]
其中 \(\gamma = 512\)。注意力得分变为
\[ s_{\textrm{XPos}}(i,j) = \mathrm{Re}\left[ \sum_{t} \tilde{q}_i^{(t)}\, \overline{\tilde{k}_j^{(t)}}\, \zeta_t^{(i-j)/\gamma} \exp(\mathrm{i}(i-j)\theta_t) \right], \]
它仍然只依赖于 \(i - j\);当 \(i \ge j\)(因果注意力)时,每个频带都会乘上衰减因子 \(\zeta_t^{(i-j)/\gamma}\)。快频带(\(t\) 小、\(\zeta_t\) 小)衰减迅速,因此只对邻近词元有影响;慢频带(\(\zeta_t \to 1\))则几乎不衰减。推理时,XPos 还会结合分块因果注意力,以外推到更长的序列。
不过,其实验规模较小:一个与 GPT-3 Medium 相当的模型(24 层、隐藏维度 1024)从头训练,训练长度为 1024,并且仅在 arXiv 上评估到 4096,也就是训练长度的 4 倍。结合分块因果注意力后,困惑度持续下降(在 1024 / 2048 / 4096 长度下为 23.31 → 21.6 → 20.73),但普通 RoPE 配合分块因果注意力后,困惑度也不再暴涨(25.57 / 25.65,而不使用分块因果注意力时为 73.6 / 294.45)。不使用分块因果注意力时,XPos 的表现仍会退化(2048 时为 22.56,4096 时为 28.43),因此单靠衰减并没有解决外推问题,相当一部分收益来自窗口化注意力。
对快频带施加衰减,也许有助于处理远处词元;但对于近处词元,最好保留快频带。
1.6 带线性偏置的注意力(ALiBi)
符号说明
| 符号 | 含义 |
|---|---|
| \(s_{\mathrm{ALiBi}}(i,j)\) | 加入线性距离惩罚后的注意力分数。 |
| \(H,h\) | 注意力头总数与头索引 h=1,…,H。 |
| \(m_h\) | 第 h 个头的正值距离惩罚斜率;文中的等比公式对应头数为 2 的幂的情形。 |
| \(i-j,\exp(x)\) | 因果注意力中的非负距离,以及 softmax 引入的指数权重。 |
与 XPos 类似(不过发表得更早),Press 等人 10 提出了 ALiBi,用于降低远处词元的注意力得分。ALiBi 不向 \(q\) 或 \(k\) 添加位置嵌入,而是给每个注意力得分加上一个固定、不可学习的线性惩罚项:
\[ s_{\textrm{ALiBi}}(i,j) = q_i^\top k_j - m_h\,(i-j), \qquad j \le i, \]
其中 \(m_h\) 是每个注意力头各自的斜率。对于 \(H\) 个注意力头,斜率构成一个等比数列 \(m_h = 2^{-8h/H}\),\(h = 1, \dots, H\)(例如,8 个注意力头对应 \(\frac{1}{2}, \frac{1}{4}, \dots, \frac{1}{256}\))。
XPos 将注意力得分乘以衰减因子,使远处的得分趋向 \(0\);ALiBi 则不同,它加上一个随距离增大而趋向 \(-\infty\) 的惩罚项,因此远处词元在 softmax 之后会真正受到抑制。这样,每个注意力头都相当于一个大小不同的软滑动窗口:当 \(m_h = 1/2\) 时,相距 20 个位置的词元,其权重就已经被乘以 \(e^{-10}\);而当 \(m_h = 1/256\) 时,距离为 2048 的惩罚也只有 \(-8\)。一个在长度 1024 上训练的 1.3B 模型,外推到 2048 时,困惑度与在长度 2048 上训练的正弦位置编码模型相同,而且在远长于此的长度下,困惑度仍然保持稳定。BLOOM 和 MPT 后来也采用了 ALiBi。
1.6.1 ALiBi 是一种带距离衰减的 NoPE
位置偏置 \(-m_h\,(i-j)\) 只依赖相对距离,不依赖语义。因此,与 T5 相对位置偏置一样,ALiBi 也是 NoPE 加上相对位置偏置,只不过这里的偏置是固定的,并且始终随距离衰减。由于大多数注意力头的衰减都很强,远处词元基本会被忽略,模型的行为类似于流式大语言模型。因此,从功能上看,ALiBi 类似于流式 NoPE,只是斜率最小的那些注意力头仍然能够看到远处词元。
2. 无需训练的上下文扩展
符号说明
| 符号 | 含义 |
|---|---|
| \(L,L'\) | 训练上下文长度与目标扩展上下文长度。 |
| \(s\) | 扩展倍率 L′/L>1;不是注意力分数 s(i,j)。 |
| \(i,j,t,\theta_t\) | 查询/键位置、频段索引及原始角频率。 |
一个以长度 \(L\) 的上下文训练的 RoPE 模型,之所以在更长输入上失效,主要是因为注意力得分中的角度 \((i-j)\theta_t\)
\[ s_{\textrm{RoPE}}(i,j) = \mathrm{Re}\left[ \sum_{t} \tilde{q}_i^{(t)}\, \overline{\tilde{k}_j^{(t)}}\, \exp(\mathrm{i}(i-j)\theta_t) \right] \]
超出了训练时见过的范围。若要在不改变模型架构的情况下,将其用于长度 \(L' = sL\)(\(s > 1\))的输入,可以改变频率 \(\theta_t\)(2.1),也可以改变距离 \(i - j\)(2.2)。这两类方法也都可以随当前序列长度动态调整,而不必事先固定参数(2.3)。
2.1 重新缩放频率
符号说明
| 符号 | 含义 |
|---|---|
| \(\theta_t,\theta'_t\) | 第 t 个频段的原始角频率与缩放后的角频率。 |
这类方法将旋转速度从 \(\theta_t\) 降低到 \(\theta'_t\)。它们的区别在于:每个频带分别缩放多少。
2.1.1 位置插值(PI)
符号说明
| 符号 | 含义 |
|---|---|
| \(s,m\) | 扩展倍率与插值前的词元位置。 |
| \(m/s\) | 插值后的词元位置,可以是非整数。 |
Chen 等人 11,以及同期的 kaiokendev 12,对所有频带采用相同的缩放比例:
\[ \theta'_t = \frac{\theta_t}{s}. \]
此时,位置 \(m\) 的角度与原来位置 \(m/s\) 的角度相同,因此直到 \(L'\) 的所有位置都落在训练时见过的范围内。然而,相邻词元现在只相差原来的 \(1/s\) 个位置,因此快频带会损失分辨率,PI 需要依靠微调来恢复它。通过不超过 1000 步的微调,LLaMA 的上下文长度被扩展到了 32768。
2.1.2 NTK 感知缩放
符号说明
| 符号 | 含义 |
|---|---|
| \(t,d\) | 维度对索引与偶数单头维度(本公式要求 d>2)。 |
| \(s^{-2t/(d-2)}\) | 第 t 个维度对的频率缩放系数。 |
为保留快频带,bloc97 13 对各频带采用非均匀缩放,其动机来自对傅里叶特征的 NTK 分析 14:要学习高频函数,就需要高频输入。具体做法是增大 \(\theta_t\) 中的底数,等价于
\[ \theta'_t = \theta_t \cdot s^{-2t/(d-2)}. \]
最快的频带保持不变,只有最慢的频带才完整地缩放至原来的 \(1/s\)。在不微调的情况下,这种方法比 PI 好得多。然而,其他频带的缩放幅度都小于完整的 \(1/s\) 缩放,因此其中一些频带仍会出现超出范围的角度:Peng 等人 4 报告称,微调后它的效果不如 PI,而且 \(s\) 必须设得比预期的扩展倍数更大。
2.1.3 YaRN
符号说明
| 符号 | 含义 |
|---|---|
| \(\lambda_t\) | 第 t 个频段的波长 2π/θₜ,以词元位置为单位。 |
| \(r_t\) | 训练长度内的旋转圈数 L/λₜ。 |
| \(\alpha,\beta\) | 旋转圈数的下/上阈值;文中 Llama 设置为 1 和 32。 |
| \(\gamma_t\) | 混合权重,从 0(完全插值)到 1(频率不变)。 |
| \(\tau\) | 注意力温度;q、k 各乘以 √(1/τ)。 |
| \(d,\ln,\mathrm{softmax}\) | 单头维度、自然对数,以及把分数归一化为注意力权重的 softmax。 |
Peng 等人 4 根据每个频带在训练上下文长度内旋转的圈数来决定缩放程度,圈数为 \(r_t = L / \lambda_t\),其中 \(\lambda_t = 2\pi / \theta_t\) 是波长。这种 NTK 分段插值 15 的形式为
\[ \theta'_t = (1 - \gamma_t)\, \frac{\theta_t}{s} + \gamma_t\, \theta_t, \qquad \gamma_t = \min\left(1, \max\left(0, \frac{r_t - \alpha}{\beta - \alpha}\right)\right), \]
对于 Llama,取 \(\alpha = 1\)、\(\beta = 32\)。快频带(\(r_t > \beta\))已经见过所有角度,因此保持不变。慢频带(\(r_t < \alpha\))连一圈都没有转完,因此像 PI 一样,完整地缩放至原来的 \(1/s\)。介于两者之间的频带则采用混合。
我的理解
两种方法都将每个频带的旋转速度乘以一个介于 \(1\)(保持不变)和 \(1/s\)(与 PI 相同)之间的因子。NTK 感知缩放让这个因子随频带索引 \(t\) 呈几何级数变化,分布在所有频带上:\(s^{-2t/(d-2)}\) 从最快频带的 \(1\) 开始,到最慢频带才达到 \(1/s\)。YaRN 则按旋转圈数 \(r_t\) 做线性插值,也就是按频率而不是频带索引插值;\(\alpha\) 和 \(\beta\) 以圈数为单位设定混合范围:\(r_t > \beta\) 的频带保留因子 \(1\),\(r_t < \alpha\) 的频带则完整地使用 \(1/s\)。
由于更长的上下文还会使注意力分布变得平坦,YaRN 通过温度 \(\tau\) 使其更尖锐,具体做法是将 \(q\) 和 \(k\) 都乘以 \(\sqrt{1/\tau}\):
\[ \mathrm{softmax}\left(\frac{q_i^\top k_j}{\tau\sqrt{d}}\right), \qquad \sqrt{1/\tau} = 0.1 \ln s + 1 . \]
Llama 2 7B / 13B 的训练长度为 4096,经过 400 步微调即可达到 64k(\(s = 16\)),再微调 200 步即可达到 128k(\(s = 32\)),使用的数据量约为预训练数据的 0.1%。
2.2 重新映射相对距离
符号说明
| 符号 | 含义 |
|---|---|
| \(\delta(i,j)\) | 查询 i 与键 j 之间重映射后的相对距离。 |
| \(s_\delta(i,j)\) | 使用重映射距离的注意力分数;仍保留原始频率。 |
这类方法保留 \(\theta_t\),将 \(i - j\) 替换为映射后的距离 \(\delta(i, j)\):
\[ s_{\delta}(i,j) = \mathrm{Re}\left[ \sum_{t} \tilde{q}_i^{(t)}\, \overline{\tilde{k}_j^{(t)}}\, \exp(\mathrm{i}\, \delta(i,j)\, \theta_t) \right], \qquad j \le i. \]
它们都会保留邻近词元的精确距离,因为语言建模依赖这一点;对于远处词元,则采用更粗粒度的距离。它们的区别在于粗到什么程度。
2.2.1 ReRoPE
符号说明
| 符号 | 含义 |
|---|---|
| \(w\) | 局部窗口的距离阈值,小于训练长度 L。 |
| \(\min(i-j,w)\) | 近处使用精确距离,远处将距离截断为 w。 |
修正旋转位置嵌入(Rectified RoPE)16 是最粗粒度的一种情形。它将距离限制在窗口 \(w < L\) 以内,因此所有距离超过 \(w\) 的词元看起来都一样远:
\[ \delta(i,j) = \min(i - j, w). \]
在 Llama 2 13B 上,取 \(w = 1024\) 时,4k / 8k / 16k 长度下的损失分别为 1.50 / 1.43 / 1.40;而普通 RoPE 的损失会从 4k 时的 1.50 跃升至 8k 时的 8.86。它的实现需要计算两遍注意力,而且在 An 等人 17 发表论文时,尚不兼容 FlashAttention。
这是一项工程限制,而非算法本身的限制。ReRoPE 需要为每个查询—键对计算两个注意力得分:一个采用普通 RoPE,另一个采用固定距离 \(w\),然后在 softmax 之前选择其中一个。标准 FlashAttention 内核不会暴露这些得分,因此需要定制内核,或合并多次标准注意力调用的结果。Jet-Long(2.3.2)恰好针对类似的近处/远处分离采用了这种做法,并保留了 FlashAttention-3 预填充吞吐量的 83–88%。
2.2.2 Self-Extend
符号说明
| 符号 | 含义 |
|---|---|
| \(G,w\) | 分组大小与局部窗口距离阈值。 |
| \(\lfloor x\rfloor\) | 向下取整:不大于 x 的最大整数。 |
| \(\lfloor i/G\rfloor,\lfloor j/G\rfloor\) | 查询/键所在组的索引。 |
| \(L,L'\) | 训练上下文长度与目标扩展长度。 |
Jin 等人 18 没有让所有远处词元共用一个距离,而是将它们分组:给定邻近窗口 \(w\) 和分组大小 \(G\),同一组中的词元共享位置 \(\lfloor i / G \rfloor\):
\[ \delta(i,j) = \begin{cases} i - j & i - j \le w \\ \lfloor i / G \rfloor - \lfloor j / G \rfloor + w - \lfloor w / G \rfloor & \text{otherwise.} \end{cases} \]
偏移量 \(w - \lfloor w / G \rfloor\) 使这两部分平滑衔接,上下文最多可扩展到 \((L - w)G + w\)。当 \(G\) 大到让所有远处词元都落入同一组时,ReRoPE 就是它的一个特例。
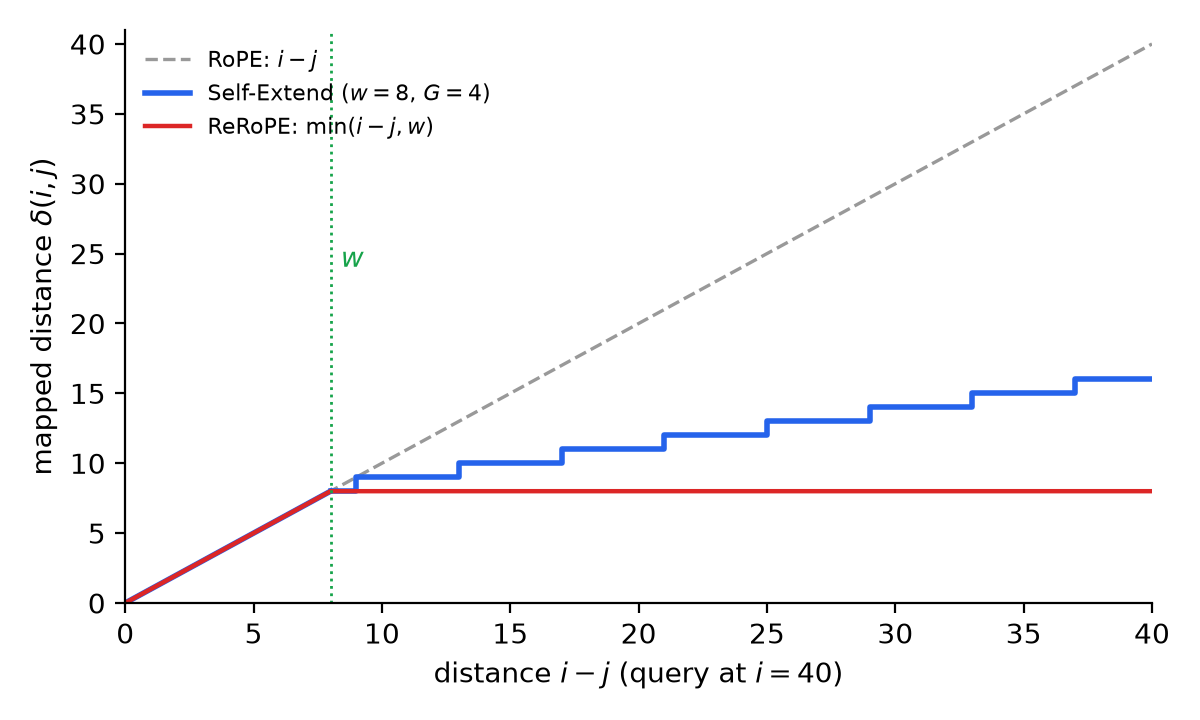
对于位置 \(i\) 处的查询,邻近词元保留精确距离,而远处词元每 \(G\) 个分成一组,映射到同一个位置,因此距离呈阶梯状变化(上图中 \(w = 8\)、\(G = 4\))。
\(G\) 根据目标长度 \(L'\) 预先选定:要覆盖 \(L'\),需要 \((L - w)G + w \ge L'\),即 \(G \ge (L' - w)/(L - w)\)。例如,对于 \(L = 4096\)、\(w = 1024\) 的 Llama 2,要扩展到 16k,就需要 \(G \ge 5\)。由于 \(G\) 固定,而且分组由绝对位置 \(\lfloor j/G \rfloor\) 决定,已缓存的键所属的组不会随序列增长而改变,因此它按分组位置旋转后的结果也可以缓存。代价是需要计算两组注意力得分(邻近得分和分组得分),再在 softmax 之前合并。
无需微调,Llama-2-7B-chat 在 PG-19 上的困惑度直到长度 12288 都维持在 9 左右,而原模型从 6144 开始就超过 \(10^3\)。Mistral 7B 在口令检索任务上的准确率达到 100%;相比之下,滑动窗口虽然困惑度较低,却无法检索窗口以外的任何内容,因此低困惑度本身并不能证明长上下文能力。
2.2.3 双分块注意力(DCA)
符号说明
| 符号 | 含义 |
|---|---|
| \(c\) | 分块大小,小于 L;不是 1.4.1 节复数的模 c。 |
| \(a,b\) | 查询/键在各自块内的位置:i mod c 与 j mod c。 |
| \(\lfloor i/c\rfloor,\lfloor j/c\rfloor\) | 查询/键所在块的索引。 |
| \(\bmod,L\) | 取余运算与训练上下文长度。 |
An 等人 17 将序列划分为大小为 \(c < L\) 的块。令 \(a = i \bmod c\)、\(b = j \bmod c\) 分别表示各自块内的位置,
\[ \delta(i,j) = \begin{cases} a - b & \lfloor i/c \rfloor - \lfloor j/c \rfloor = 0 \quad \text{(intra-chunk)} \\ \min(c + a, L - 1) - b & \lfloor i/c \rfloor - \lfloor j/c \rfloor = 1 \quad \text{(successive-chunk)} \\ L - 1 - b & \lfloor i/c \rfloor - \lfloor j/c \rfloor > 1 \quad \text{(inter-chunk)} \end{cases} \]
块内注意力保留精确距离。相邻块注意力也会为一个块的前 \(L - c\) 个位置保留精确距离,因此刚越过块边界的词元不会失去邻近词元。跨块注意力则让每个查询都采用最大位置 \(L - 1\),因此远处的键只保留其在块内的顺序。
由于 \(a \le c - 1\),上限 \(\min(c + a, L - 1)\) 只有在 \(2c > L\) 时才会生效。否则,整个前一块都处于距离 \(L - 1\) 以内,相邻块注意力对每个键都保留精确距离。An 等人 17 的示例采用 \(c = 6\)、\(L = 10\),即 \(c > L/2\)。
实现时,每个键只在其块内位置 \(b\) 旋转一次,然后缓存。每个查询则分别旋转到三个位置:\(a\)、\(\min(c + a, L - 1)\) 和 \(L - 1\),并根据键所在的块选用相应版本。这三种情形覆盖互不相交的键集合(同一块、前一块、更早的块),因此可以通过三次标准 FlashAttention 调用计算注意力,再利用它们的 log-sum-exp 统计量合并,总计算成本与全注意力相同。
DCA 可以叠加在采用 PI 或 NTK 感知缩放的模型之上。无需微调,它就能将 Llama 2 70B 从 4k 扩展到 96k,困惑度仅增加 0.56。
2.2.4 按维度操作位置嵌入(DPE)
符号说明
| 符号 | 含义 |
|---|---|
| \(g,e_g\) | 频段组索引与第 g 组测得的有效长度。 |
| \(l\) | 当前序列长度;不是 1.3 节的层索引 l。 |
| \(\sigma_g\) | 第 g 组的距离压缩倍率 ⌊l/e_g⌋,公式用于该倍率为正的扩展情形。 |
| \(\delta_t(i,j)\) | 专门针对第 t 个频段的重映射距离。 |
| \(\lVert q^{(t)}\rVert\lVert k^{(t)}\rVert\) | 查询/键维度对的范数乘积,用作贡献度指标(省略位置索引)。 |
| \(w,t,d\) | 局部窗口阈值、维度对索引与偶数单头维度。 |
上述方法对所有频带采用相同的 \(\delta\)。Lu 等人 19 则分别重新映射各个频带,其依据是他们在 Llama 3 8B 上的两个发现:
- 不同频带的有效长度不同:当距离超出训练范围时,最快和最慢的频带仍然有效,而中间频带会立即失效。
- 只有一部分频带重要:贡献 \(\lVert q^{(t)} \rVert \lVert k^{(t)} \rVert\) 大多来自少数几个频带,而这些频带因注意力头和层而异。
因此,DPE 将频带分为 8 组,并通过检索任务测量每组的有效长度 \(e_g\)。对于每个注意力头,它根据上述贡献选出前 48 个频带,只重新映射这些频带,其余频带仍使用 \(i - j\)。对于第 \(g\) 组中一个被选中的频带 \(t\),取局部窗口 \(w = 1\)k,
\[ \delta_t(i,j) = \begin{cases} \lfloor (i - j - w) / \sigma_g \rfloor + w & i - j > w \\ i - j & \text{otherwise,} \end{cases} \qquad \sigma_g = \lfloor l / e_g \rfloor , \]
其中 \(l\) 是序列长度。无需微调,DPE 将 Llama 3 8B 从 8k 扩展到 128k,在“大海捞针”(Needle-in-a-Haystack)任务上的准确率达到 92.5%(Self-Extend:89.5%,ReRoPE:78%,DCA:53%,YaRN:0%)。
YaRN 对最慢的频带采用完整插值,而 DPE 的发现不同:这些频带能够容忍更长的距离。一个可能的解释是(并非来自论文):Llama 3 采用底数 \(500000\),而非 \(10000\),因此最慢的频带(最后一组,\(t \ge 56\))即使在 128k 时也转不到四分之一圈;相比之下,中间频带在 8k 内最多只旋转几圈,到 128k 时却会多转很多圈。
2.3 随当前长度动态调整
符号说明
| 符号 | 含义 |
|---|---|
| \(l,L,s,G\) | 当前长度、训练长度、频率扩展倍率与距离分组大小。 |
上述方法预先固定 \(s\) 或 \(G\),其中存在一种权衡:取值过大会损害短输入的表现,取值过小又会在长输入上失效。另一种做法是让参数随当前序列长度 \(l\) 动态调整,使模型在 \(l \le L\) 时保持不变。
2.3.1 动态缩放
符号说明
| 符号 | 含义 |
|---|---|
| \(s=\max(1,l/L)\) | 随长度变化的扩展倍率;训练长度以内等于 1。 |
频率缩放类方法可以在每次前向传播时更新 \(s\),使模型在超出 \(L'\) 后逐步退化,而不是突然失效:
\[ s = \max(1, l / L). \]
将它与 NTK 感知缩放结合,就是动态 NTK 20。动态 YaRN 无需任何微调,就能实现超过 2 倍的上下文扩展。由于每个词元的旋转都会随 \(s\) 改变,KV 缓存必须存储应用 RoPE 之前的键。
动态 NTK 和动态 YaRN 就是 NTK 和 YaRN 的动态版本。它们每次前向传播都需要旋转所有键。
2.3.2 Jet-Long
符号说明
| 符号 | 含义 |
|---|---|
| \(G=\max(1,\lceil l/L\rceil)\) | 动态分组大小;ceil 表示向上取整。 |
| \(w,i,j\) | 局部窗口距离阈值与查询/键位置。 |
| \(f(k_j,j)\) | 按原始位置旋转并存入 KV 缓存的键。 |
| \(\lfloor j/G\rfloor-j\) | 将缓存键旋转到当前分组位置所使用的位置修正量。 |
Tang 等人 21 将这一思路应用于分组。他们采用能够让所有位置都保持在范围内的最小分组大小:
\[ G = \max\left(1, \lceil l / L \rceil\right), \qquad \delta(i,j) = \begin{cases} i - j & i - j \le w \\ \lfloor i / G \rfloor - \lfloor j / G \rfloor & \text{otherwise.} \end{cases} \]
唯一的超参数是 \(w\)(主要实验中取 2048)。由于 \(G\) 会在生成过程中改变,KV 缓存保留按原始位置旋转后的键 \(f(k_j, j)\),并在计算时即时施加对应于位置差 \(\lfloor j/G \rfloor - j\) 的校正旋转(查询同理),因为旋转角度可以相加。缓存始终不被重写,不过,较早词元的隐藏状态也不会重新计算。
\(G\) 根据当前长度计算:预填充阶段使用完整提示词长度,解码阶段则随着新增词元更新,因此只有当 \(l\) 跨过 \(L\) 的整数倍时,\(G\) 才会改变。每一步都会对所有远处的键施加校正旋转,但这只是逐元素运算,并且被融合到注意力内核中,而不会写回缓存;借此,8B 模型的解码吞吐量达到了 FlashAttention-3 的 1.04–1.08 倍。
在 Qwen3 1.7B / 4B / 8B(训练长度为 32k)上,无需微调、扩展到最高 128k 时,Jet-Long 在 RULER 上分别领先最强基线 4.79 / 2.18 / 2.03 分,并在 64k–128k 长度下保留了 FlashAttention-3 预填充吞吐量的 83–88%。
Jet-Long 是 Self-Extend 的动态版本。类似地,它每次前向传播都需要旋转所有键。
参考文献
[1] VASWANI A, SHAZEER N, PARMAR N, et al. Attention is All you Need[C/OL]//GUYON I, LUXBURG U V, BENGIO S, et al. Advances in Neural Information Processing Systems. Curran Associates, Inc., 2017. https://proceedings.neurips.cc/paper_files/paper/2017/file/3f5ee243547dee91fbd053c1c4a845aa-Paper.pdf.
[2] DEVLIN J, CHANG M-W, LEE K, et al. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding[C]//BURSTEIN J, DORAN C, SOLORIO T. Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long and Short Papers). Minneapolis, Minnesota: Association for Computational Linguistics, 2019: 4171-4186. DOI: 10.18653/v1/N19-1423.
[3] RADFORD A, NARASIMHAN K, SALIMANS T, et al. Improving language understanding by generative pre-training[J]. 2018.
[4] PENG B, QUESNELLE J, FAN H, et al. YaRN: Efficient Context Window Extension of Large Language Models[C/OL]//The Twelfth International Conference on Learning Representations. 2024. https://openreview.net/forum?id=wHBfxhZu1u.
[5] RAFFEL C, SHAZEER N, ROBERTS A, et al. Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer[J/OL]. Journal of Machine Learning Research, 2020, 21(140): 1-67. http://jmlr.org/papers/v21/20-074.html.
[6] SU J, AHMED M, LU Y, et al. RoFormer: Enhanced transformer with Rotary Position Embedding[J]. Neurocomputing, 2024, 568: 127063. DOI: 10.1016/j.neucom.2023.127063.
[7] HAVIV A, RAM O, PRESS O, et al. Transformer Language Models without Positional Encodings Still Learn Positional Information[C]//GOLDBERG Y, KOZAREVA Z, ZHANG Y. Findings of the Association for Computational Linguistics: EMNLP 2022. Abu Dhabi, United Arab Emirates: Association for Computational Linguistics, 2022: 1382-1390. DOI: 10.18653/v1/2022.findings-emnlp.99.
[8] BARBERO F, VITVITSKYI A, PERIVOLAROPOULOS C, et al. Round and Round We Go! What makes Rotary Positional Encodings useful?[C/OL]//The Thirteenth International Conference on Learning Representations. 2025. https://openreview.net/forum?id=GtvuNrk58a.
[9] SUN Y, DONG L, PATRA B, et al. A Length-Extrapolatable Transformer[C]//ROGERS A, BOYD-GRABER J, OKAZAKI N. Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers). Toronto, Canada: Association for Computational Linguistics, 2023: 14590-14604. DOI: 10.18653/v1/2023.acl-long.816.
[10] PRESS O, SMITH N, LEWIS M. Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation[C/OL]//International Conference on Learning Representations. 2022. https://openreview.net/forum?id=R8sQPpGCv0.
[11] CHEN S, WONG S, CHEN L, et al. Extending Context Window of Large Language Models via Positional Interpolation[Z/OL]. arXiv:2306.15595, 2023. https://arxiv.org/abs/2306.15595.
[12] kaiokendev. Things I’m Learning While Training SuperHOT[EB/OL]. Blog post, (2023). https://kaiokendev.github.io/til#extending-context-to-8k.
[13] bloc97. NTK-Aware Scaled RoPE allows LLaMA models to have extended (8k+) context size without any fine-tuning[EB/OL]. Reddit post, r/LocalLLaMA, (2023). https://www.reddit.com/r/LocalLLaMA/comments/14lz7j5/ntkaware_scaled_rope_allows_llama_models_to_have/.
[14] TANCIK M, SRINIVASAN P, MILDENHALL B, et al. Fourier Features Let Networks Learn High Frequency Functions in Low Dimensional Domains[C/OL]//LAROCHELLE H, RANZATO M, HADSELL R, et al. Advances in Neural Information Processing Systems. Curran Associates, Inc., 2020: 7537-7547. https://proceedings.neurips.cc/paper_files/paper/2020/file/55053683268957697aa39fba6f231c68-Paper.pdf.
[15] bloc97. Add NTK-Aware interpolation “by parts” correction[EB/OL]. GitHub pull request, (2023). https://github.com/jquesnelle/yarn/pull/1.
[16] SU J. Rectified Rotary Position Embeddings[EB/OL]. GitHub repository, (2023). https://github.com/bojone/rerope.
[17] AN C, HUANG F, ZHANG J, et al. Training-Free Long-Context Scaling of Large Language Models[C/OL]//SALAKHUTDINOV R, KOLTER Z, HELLER K, et al. Proceedings of the 41st International Conference on Machine Learning. PMLR, 2024: 1493-1510. https://proceedings.mlr.press/v235/an24b.html.
[18] JIN H, HAN X, YANG J, et al. LLM Maybe LongLM: SelfExtend LLM Context Window Without Tuning[C/OL]//SALAKHUTDINOV R, KOLTER Z, HELLER K, et al. Proceedings of the 41st International Conference on Machine Learning. PMLR, 2024: 22099-22114. https://proceedings.mlr.press/v235/jin24b.html.
[19] LU Y, ZHAO W, ZHOU X, et al. Effective Length Extrapolation via Dimension-Wise Positional Embeddings Manipulation[C/OL]//Conference on Language Modeling. 2025. https://openreview.net/forum?id=Tahpc3iAnO.
[20] emozilla. Dynamically Scaled RoPE further increases performance of long context LLaMA with zero fine-tuning[EB/OL]. Reddit post, r/LocalLLaMA, (2023). https://www.reddit.com/r/LocalLLaMA/comments/14mrgpr/dynamically_scaled_rope_further_increases/.
[21] TANG H, WANG Z, GU Y, et al. Jet-Long: Efficient Long-Context Extension with Dynamic Bifocal RoPE[Z/OL]. arXiv:2607.07740, 2026. https://arxiv.org/abs/2607.07740.